AdvancedIF
📌 核心贡献
构建 AdvancedIF benchmark(1,600+ prompts,专家标注 rubric),并提出 RIFL 训练流程(rubric 生成 + 微调 verifier + reward shaping),在 AdvancedIF 上实现 6.7% 绝对提升,为复杂多轮指令跟随场景提供了标准化评估和训练方案。
📖 摘要
The authors present a benchmark with over 1,600 prompts and expert-curated rubrics that assess LLMs ability to follow complex, multi-turn, and system-level instructions. They introduce RIFL, which leverages rubric generation, a finetuned rubric verifier, and reward shaping to enable effective reinforcement learning. Results show a 6.7% absolute gain on AdvancedIF and strong results on public benchmarks.
🔍 关键信息
| 字段 | 内容 |
|---|---|
| 机构 | Meta Superintelligence Labs, Princeton University, CMU |
| 发表 | 2025-11-13 |
| 分类 | cs.CL |
| 链接 | arXiv |
📝 我的笔记
方法总览
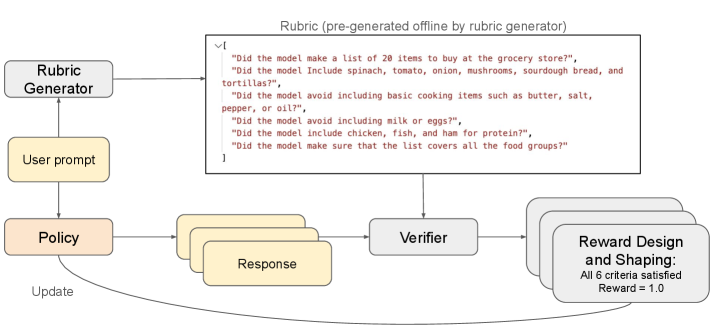
核心问题/动机
现有 instruction following 评估存在两个关键不足:
- Benchmark 不足:现有 benchmark(如 IFEval)主要关注简单、可验证的格式约束,缺乏对复杂多轮对话、system prompt 约束、上下文携带等高级场景的覆盖
- 训练信号缺失:开放式指令跟随缺乏 binary verifiable reward,传统 RLHF 的 learned RM 容易被 gaming
AdvancedIF 同时解决评估和训练两个问题:提供 expert-curated rubric 作为评估标准,并用 RIFL 将其转化为训练信号。
方法
1. AdvancedIF Benchmark
1,645 个 prompts,覆盖三类高级指令跟随能力:
- Complex:复杂多约束指令
- Carried Context:多轮对话中上下文携带
- System:system-level 指令约束
每个 prompt 配有专家手写的 rubric(评分标准),而非自动生成。
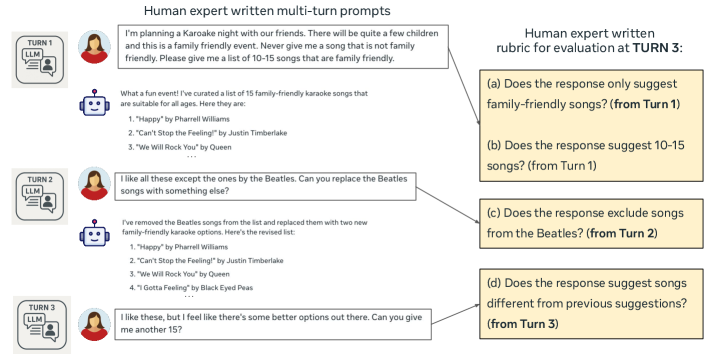
2. RIFL 训练流程
Step 1: Rubric 生成器
在非 AdvancedIF 的独立 prompt 上微调 Llama 4 Maverick,学习生成 rubric:
- 训练数据:专家标注的 rubric
- F1: 0.790(vs 基线 0.639)
Step 2: Rubric Verifier 训练(两阶段)
SFT 阶段:在 ~5K prompts 的专家评估数据上微调,学习 chain-of-thought rubric 验证。
RL 阶段:在 ~14K prompts 上进行 RL 训练,reward 为与专家标签的匹配度(binary matching)。
微调 verifier F1: 0.728(vs vanilla Llama 0.515,接近 o3-mini 的 0.723)。
Step 3: Reward Shaping
其中 verifier 将 映射为 维二值标签,reward 为:
即所有 rubric 项全部满足才获得正 reward(严格指示函数)。
额外添加两个 anti-gaming 约束:
- 输出不含 artifacts(乱码、重复等)
- 输出完整性检查
关键结果
AdvancedIF Benchmark
| 模型 | Complex | Carried Context | System | Average |
|---|---|---|---|---|
| Llama 4 Maverick (base) | 60.7% | 51.0% | 42.4% | 51.4% |
| + RIFL | 66.4% | 56.4% | 51.5% | 58.1% |
| 提升 | +5.7 | +5.4 | +9.1 | +6.7 |
公开 Benchmark
| Benchmark | Base → RIFL |
|---|---|
| MultiChallenge | 37.4% → 40.3% (+2.9) |
| IFEval | 89.9% → 90.0% (+0.1) |
IFEval 提升极小因为已接近饱和。
SoTA 参考(AdvancedIF)
| 模型 | Average |
|---|---|
| GPT-5 | 77.9% |
| Gemini 3 Pro | 74.7% |
| Claude 4 Sonnet | 63.8% |
| Llama 4 Maverick + RIFL | 58.1% |
总结
AdvancedIF 的价值更多在 benchmark 贡献而非训练方法本身。Expert-curated rubric 提供了高质量的评估标准,弥补了 IFEval 等 benchmark 对高级指令跟随场景的覆盖不足。
RIFL 的训练流程相对直接(rubric 生成→verifier 微调→RL),核心创新在于用两阶段(SFT + RL)训练 rubric verifier 替代直接用 LLM-as-judge。严格的 indicator reward(全部满足才得分)是一个值得注意的设计选择——与 RaR 的加权聚合形成对比。
🔗 相关论文
基于/改进自: —
同方向: RaR, RRD, Rubric-ARM, Checklists